Operamos un backend pequeño para Office Claws: una API en Go, Postgres, un reverse proxy Caddy y un proxy LiteLLM autoalojado, todo en un único stack de Docker Compose sobre un solo VPS. LiteLLM es el gateway LLM. Durante el aprovisionamiento, el backend le pide que genere una clave virtual con presupuesto limitado para cada agente nuevo.
Es una configuración corriente y, aun así, se rompió tres veces en una sola semana de junio. Ninguno de los fallos fue exótico. Cada uno pasó desapercibido durante un tiempo, y por eso dolió. Este es el build log: qué vimos, qué estaba mal de verdad, qué cambiamos y la lección que le pasaríamos a cualquiera que opere un stack autoalojado parecido.
| # | Incidente | Cómo se manifestó | Arreglo |
|---|---|---|---|
| 1 | Tag de imagen móvil + límite de memoria ajustado | El onboarding del agente fallaba con un error vago en el cliente | Fijar por digest, subir el límite, fallar de forma visible |
| 2 | Las migraciones del gateway borraron un esquema compartido | relation "users" does not exist tras un reinicio | Base de datos separada para el gateway |
| 3 | $ en un secreto, interpolado por Compose | El servicio arrancaba bien, el secreto era incorrecto en silencio | Escapar como $$, revisar compose config |
Incidente 1: un tag móvil trajo una build más pesada y entró en bucle de OOM
Síntoma. Los agentes nuevos dejaron de completar la configuración. La app de escritorio fallaba en el paso de onboarding con "LiteLLM virtual key and base URL are required". Ese mensaje llegaba minutos después de que la petición de aprovisionamiento ya hubiera devuelto éxito, así que primero sospechamos del cliente.
Causa raíz. Nuestro archivo compose referenciaba LiteLLM con un tag móvil:
litellm:
  image: ghcr.io/berriai/litellm:main-stable
  deploy:
    resources:
      limits:
        memory: 1500M
Un despliegue rutinario descargó lo que main-stable apuntara ese día. La nueva build necesitaba unos 2,1 GiB para arrancar con dos workers. Con un límite de 1500M, el kernel la mataba antes de terminar de calentarse, Docker la reiniciaba y el ciclo se repetía aproximadamente cada 62 segundos. Cuando lo detectamos, el contenedor se había reiniciado 4.088 veces a lo largo de unos tres días.
Dos cosas lo mantuvieron oculto:
- Nuestro backend se tragaba el fallo. Cuando fallaba la generación de la clave, el handler de aprovisionamiento registraba un warning y devolvía
200con los campos LLM vacíos. El error real solo aparecía más tarde, en el cliente, como un mensaje genérico. - El diagnóstico obvio mentía.
docker inspectmostraba unRestartCounty unExitCodeque parecían sanos cuando mirábamos a mitad del ciclo. Lo que de verdad reveló el bucle fue observar los eventos en vivo:
docker events --filter container=<litellm-container> --filter event=oom --filter event=die
# ... oom
# ... die (exitCode=137)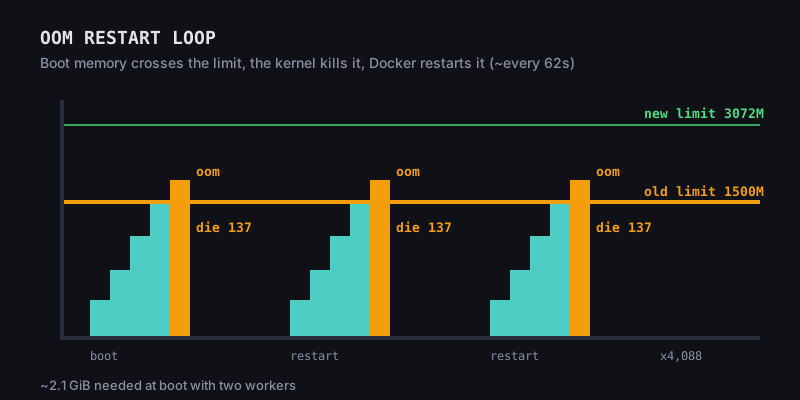
Arreglo. Tres cambios en un solo PR:
litellm:
  # Pinned by digest. Bump deliberately: verify boot memory fits the limit first.
  image: ghcr.io/berriai/litellm@sha256:<digest-you-tested>
  deploy:
    resources:
      limits:
        # Boot memory of the pinned image is ~2.1G with two workers.
        memory: 3072M
Y en el handler de aprovisionamiento, un fallo al generar la clave ahora es un 502 explícito (o 503 si el gateway no está configurado) en lugar de un 200 con campos vacíos. Un fallo que el usuario puede reintentar al momento es mejor que uno que aparece después como un error confuso.
Para encontrar el digest de la imagen que realmente has probado:
docker buildx imagetools inspect ghcr.io/berriai/litellm:main-stable
# or, for an image already pulled on the host:
docker inspect --format '{{index .RepoDigests 0}}' ghcr.io/berriai/litellm:main-stable
Lección. Un tag móvil significa una actualización sin revisar en cada despliegue, y un límite de memoria dimensionado para la imagen del mes pasado acabará quedándose corto. Fija por digest las imágenes de las que dependes y trata una actualización como un cambio que pruebas en memoria de arranque, no como algo que ocurre como efecto secundario de un despliegue. Además, cuando una dependencia es obligatoria, falla en el punto de la petición. Los fallbacks que parecen opcionales son donde empiezan los incidentes silenciosos.
Incidente 2: las migraciones del gateway borraron las tablas de nuestro backend
Síntoma. Tras un reinicio, el registro y el login empezaron a fallar con:
ERROR: relation "users" does not exist (SQLSTATE 42P01)Lo raro: los logs del backend mostraban nuestras propias migraciones aplicándose sin problemas al arrancar. Una comprobación rápida justo después del reinicio parecía correcta. Un minuto después, las tablas habían desaparecido.
Causa raíz. Habíamos apuntado ambos servicios a la misma base de datos de Postgres para mantener la configuración pequeña:
# backend.env
DB_DSN=postgresql://app:<password>@postgres:5432/app

# litellm.env
DATABASE_URL=postgresql://app:<password>@postgres:5432/app   # same database
LiteLLM gestiona su esquema con Prisma. En cada arranque compara la base de datos en vivo con su propio schema.prisma. Las tablas de nuestro backend (usuarios, agentes, registros de VPS, etc.) no existen en el esquema de LiteLLM, así que para Prisma parecían drift. Su respuesta fue resetear el esquema y volver a aplicar sus propias migraciones, lo que eliminó todas las tablas que no eran suyas.
El reset se ejecutaba unos 40 a 70 segundos después del arranque. Ese retraso explicaba los logs confusos. Nuestro backend creaba sus tablas, el gateway terminaba su diff y las borraba, y cualquier comprobación hecha en el primer minuto parecía correcta.
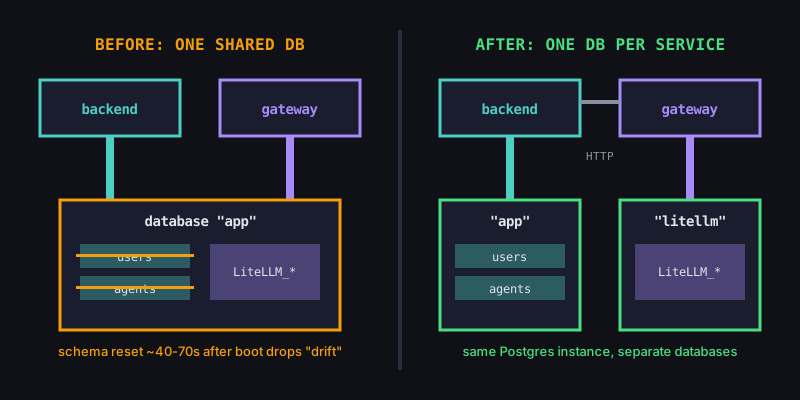
Arreglo. Dar al gateway su propia base de datos. El backend habla con LiteLLM solo por HTTP y nunca lee sus tablas, así que no había ningún motivo para compartir una.
CREATE DATABASE litellm OWNER app;# litellm.env
DATABASE_URL=postgresql://app:<password>@postgres:5432/litellmDespués, recrea el gateway para que construya sus tablas en litellm, reinicia el backend para que recree las suyas en app y elimina de la base de datos antigua las tablas huérfanas del gateway. Para verificarlo, reiniciamos el gateway otra vez, esperamos a que pasara la ventana del diff y confirmamos que nuestras tablas sobrevivían y que el registro devolvía 200.
Lección. Los servicios de terceros que gestionan su propio esquema dan por hecho que la base de datos entera es suya. No dejes que dos herramientas de migraciones compartan un esquema a menos que ambas lo soporten explícitamente. Bases de datos separadas en la misma instancia de Postgres no cuestan casi nada. Además, si un fallo llega con retraso, vuelve a comprobar después de ese retraso: una comprobación un minuto después del arranque no habría detectado este. Por último, actualiza el runbook. Después del arreglo, nuestras propias notas de configuración seguían describiendo la base de datos compartida, lo que significa que reconstruir a partir de ellas traería el bug de vuelta.
Incidente 3: un $ en un secreto se vació en silencio
Síntoma. Casi nada, y eso es lo que da miedo. El backend arrancó y registró que su cliente del proveedor cloud estaba inicializado. Esa comprobación de arranque solo confirmaba que la credencial no estaba vacía. La credencial en sí era incorrecta, así que cualquier llamada real a la API habría fallado la autenticación.
La única pista visible era un warning en docker compose up que era fácil pasar por alto:
WARN[0000] The "Xk9def" variable is not set. Defaulting to a blank string.Xk9def no era ninguna variable que hubiéramos definido (el valor aquí es inventado). Eran los caracteres que seguían a un $ dentro de uno de nuestros secretos.
Causa raíz. Docker Compose v2 interpola los valores de los archivos env_file. Un secreto como este:
PROVIDER_API_PASSWORD=abc$Xk9defse lee como abc + el valor de $Xk9def (sin definir, así que vacío). Compose pasa al contenedor el valor recortado e incorrecto sin ningún error.
Arreglo. Escapa cada $ literal como $$ al escribir archivos env y luego recrea el contenedor:
sed -i '/^PROVIDER_API_PASSWORD=/ s/\$/$$/g' secrets/backend.env
docker compose up -d --force-recreate backend
También añadimos una comprobación después de escribir cualquier archivo de secretos. Debe devolver cero coincidencias:
docker compose config 2>&1 | grep "is not set"Una trampa más: la imagen de nuestro backend es mínima, así que docker exec <ctr> printenv falla, y el texto del error puede parecer un valor. Para comprobar qué recibió realmente el contenedor sin imprimir el secreto, compara hashes:
docker inspect <ctr> --format '{{range .Config.Env}}{{println .}}{{end}}' \
  | grep '^PROVIDER_API_PASSWORD=' | cut -d= -f2- | shasum -a 256
Lección. Tu cargador de configuración es un parser y tiene sus propias reglas sobre caracteres especiales. Averigua cuáles son antes de pegar en él una contraseña generada al azar. Una comprobación de arranque que solo verifica que algo "no esté vacío" dejará pasar un secreto corrupto. Si puedes, valida las credenciales con una petición real al arrancar y trata los warnings de interpolación como errores.
Qué cambiamos en conjunto
Los arreglos fueron pequeños. El resultado más útil es una checklist corta que ahora aplicamos a cada servicio del stack:
- Fija las imágenes por digest para todo lo que tenga estado o esté en la ruta crítica. Actualiza a propósito y, cuando lo hagas, compara la memoria de arranque con el límite.
- Dimensiona los límites de memoria a partir de picos de arranque medidos, no de estimaciones del estado estable, y deja margen.
- Vigila
docker eventsen busca deoomydie. No te fíes solo de una captura puntual dedocker inspect. - Una base de datos por servicio que ejecute sus propias migraciones.
- Verifica después del retraso, no solo justo tras un reinicio.
- Falla de forma visible en la petición cuando una dependencia obligatoria está caída. Nada de
200con campos vacíos. - Ejecuta
docker compose configtras editar archivos env y trata "variable is not set" como bloqueante. - Mantén el runbook sincronizado con el arreglo, o la próxima reconstrucción traerá el bug de vuelta.
Nada de esto es específico de los gateways LLM. Se aplica a cualquier stack autoalojado pequeño donde despliega una sola persona y nadie recibe una alerta a las 3 de la madrugada. Para más sobre cómo operar servicios en un VPS, consulta nuestra guía de OpenClaw autoalojado, monitorización de OpenClaw y gestión de secretos en OpenClaw. Para un build log anterior, mira cómo dejamos el aprovisionamiento por debajo de 3 minutos.
Ejecutar agentes sin operar tú mismo el gateway
Si quieres agentes de Codex en un VPS pero no quieres operar este tipo de stack, ese es el trabajo que hace Office Claws. Tus agentes se ejecutan en tu propio VPS de Contabo, Codex usa tu suscripción existente de ChatGPT y Office Claws cuesta $4.99/mes. Instala la CLI con:
curl -fsSL https://officeclaws.com/downloads/install.sh | sh