我们为 Office Claws 运行着一个小型后端:一个 Go API、Postgres、Caddy 反向代理,以及一个自托管的 LiteLLM 代理,全部放在单台 VPS 上的同一个 Docker Compose 栈中。LiteLLM 就是 LLM 网关。在开通过程中,后端会请求它为新的智能体签发一个有预算上限的虚拟密钥。
这套架构很普通,但在六月的一周内依然出了三次故障。没有一次是罕见的问题。每一次都安静地持续了一段时间,这正是它们造成伤害的原因。这篇构建日志记录了:我们看到了什么、真正的问题是什么、我们改了什么,以及我们想分享给任何运行类似自托管栈的人的经验。
| # | 事故 | 表现 | 修复 |
|---|---|---|---|
| 1 | 浮动镜像标签 + 过紧的内存限制 | 智能体接入失败,客户端报错含糊 | 按 digest 固定、提高限制、显式失败 |
| 2 | 网关迁移清空了共享 schema | 重启后出现 relation "users" does not exist | 为网关使用独立数据库 |
| 3 | 密钥中的 $ 被 Compose 插值 | 服务正常启动,密钥却被静默改错 | 转义为 $$,检查 compose config |
事故 1:浮动标签拉取了更重的构建,陷入 OOM 循环
症状。 新的智能体无法完成设置。桌面应用在接入步骤失败,提示「LiteLLM virtual key and base URL are required」。这条消息出现在开通请求已经返回成功的几分钟之后,所以我们最初把矛头指向了客户端。
根本原因。 我们的 compose 文件通过浮动标签引用 LiteLLM:
litellm:
  image: ghcr.io/berriai/litellm:main-stable
  deploy:
    resources:
      limits:
        memory: 1500M
一次常规部署拉取了当天 main-stable 指向的版本。新构建在两个 worker 下启动需要约 2.1 GiB 内存。在 1500M 的限制下,内核在它完成预热之前就将其杀死,Docker 重启它,这个循环大约每 62 秒重复一次。等我们发现时,容器已经在约三天内重启了 4,088 次。
有两件事让它保持了沉默:
- 我们的后端吞掉了错误。 密钥签发失败时,开通处理程序只记录了一条警告,然后返回带有空 LLM 字段的
200。真正的错误直到后来才在客户端以一条笼统的消息出现。 - 最直观的诊断手段骗了我们。 我们在循环中途检查时,
docker inspect显示的RestartCount和ExitCode看起来都很正常。真正暴露循环的是实时观察事件:
docker events --filter container=<litellm-container> --filter event=oom --filter event=die
# ... oom
# ... die (exitCode=137)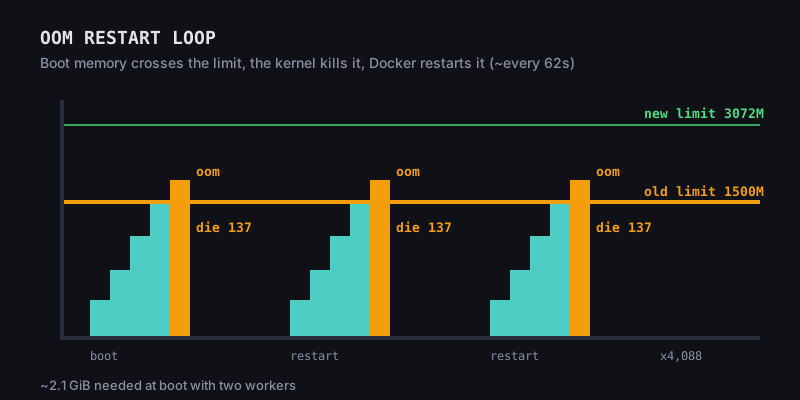
修复。 一个 PR 中的三处改动:
litellm:
  # Pinned by digest. Bump deliberately: verify boot memory fits the limit first.
  image: ghcr.io/berriai/litellm@sha256:<digest-you-tested>
  deploy:
    resources:
      limits:
        # Boot memory of the pinned image is ~2.1G with two workers.
        memory: 3072M
此外,在开通处理程序中,密钥签发失败现在会直接返回 502(如果网关未配置则返回 503),而不是带空字段的 200。一个用户可以立即重试的失败,好过一个稍后才以令人困惑的错误出现的失败。
查找你实际测试过的镜像的 digest:
docker buildx imagetools inspect ghcr.io/berriai/litellm:main-stable
# or, for an image already pulled on the host:
docker inspect --format '{{index .RepoDigests 0}}' ghcr.io/berriai/litellm:main-stable
经验。 浮动标签意味着每次部署都会带来一次未经审查的升级,而为上个月镜像设定的内存限制迟早会不够用。按 digest 固定你依赖的镜像,把升级当作一次需要测试启动内存的变更,而不是部署的副作用。另外,当某个依赖是必需的,就在请求发生的地方失败。看起来「可选」的降级逻辑,正是静默事故的起点。
事故 2:网关的迁移删除了我们的后端表
症状。 一次重启之后,注册和登录开始失败,报错如下:
ERROR: relation "users" does not exist (SQLSTATE 42P01)奇怪的是:后端日志显示我们自己的迁移在启动时顺利完成。重启后立即做的快速检查看起来也没问题。一分钟后,表就不见了。
根本原因。 为了让架构保持精简,我们让两个服务指向同一个 Postgres 数据库:
# backend.env
DB_DSN=postgresql://app:<password>@postgres:5432/app

# litellm.env
DATABASE_URL=postgresql://app:<password>@postgres:5432/app   # same database
LiteLLM 用 Prisma 管理自己的 schema。每次启动时,它都会把线上数据库与自己的 schema.prisma 做差异比对。我们后端的表(用户、智能体、VPS 记录等)不存在于 LiteLLM 的 schema 中,所以在 Prisma 看来它们就是漂移。它的应对方式是重置 schema 并重新应用自己的迁移,从而删除了所有不属于它的表。
重置发生在启动后大约 40 到 70 秒。这个时间差解释了那些令人困惑的日志:我们的后端创建了表,网关完成差异比对后把它们清空,而任何在第一分钟内做的检查看起来都正常。
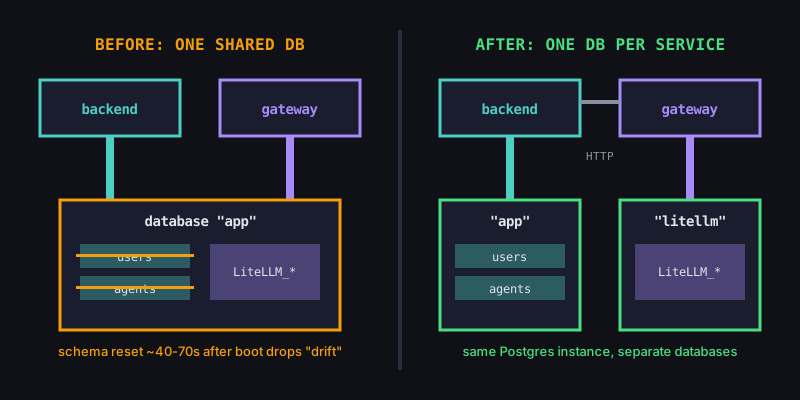
修复。 给网关一个独立的数据库。后端只通过 HTTP 与 LiteLLM 通信,从不读取它的表,因此它们根本没有理由共享一个数据库。
CREATE DATABASE litellm OWNER app;# litellm.env
DATABASE_URL=postgresql://app:<password>@postgres:5432/litellm然后重建网关,让它在 litellm 中建表;重启后端,让它在 app 中重建自己的表;再从旧数据库中删除残留的网关表。为了验证,我们再次重启网关,等过了差异比对的时间窗口,确认我们的表依然存在,注册也返回了 200。
经验。 自行管理 schema 的第三方服务会默认整个数据库都归它所有。除非两种迁移工具都明确支持,否则不要让它们共享同一个 schema。在同一个 Postgres 实例上建立独立数据库几乎没有成本。另外,如果故障是延迟发生的,就在延迟之后再检查一次:启动一分钟时做的检查是发现不了这个问题的。最后,更新运维手册。修复之后,我们自己的部署笔记仍然描述的是共享数据库,这意味着照着笔记重建会让这个 bug 原样回来。
事故 3:密钥中的 $ 被静默置空
症状。 几乎什么都没有,这正是可怕之处。后端正常启动,并记录了云服务商客户端已初始化。那个启动检查只确认了凭据非空。凭据本身是错的,所以任何真实的 API 调用都会认证失败。
唯一可见的线索是 docker compose up 时一条很容易被滚动略过的警告:
WARN[0000] The "Xk9def" variable is not set. Defaulting to a blank string.Xk9def 并不是我们定义过的变量(这里的值是虚构的)。它是我们某个密钥值中紧跟在 $ 后面的字符。
根本原因。 Docker Compose v2 会对 env_file 文件中的值进行插值。像这样的密钥:
PROVIDER_API_PASSWORD=abc$Xk9def会被读成 abc + $Xk9def 的值(未设置,因此为空)。Compose 会把这个被截短的错误值传给容器,且不报任何错误。
修复。 写入 env 文件时,把每个字面量 $ 转义为 $$,然后重建容器:
sed -i '/^PROVIDER_API_PASSWORD=/ s/\$/$$/g' secrets/backend.env
docker compose up -d --force-recreate backend
我们还在写入任何密钥文件后增加了一项检查,结果必须为零命中:
docker compose config 2>&1 | grep "is not set"还有一个陷阱:我们的后端镜像很精简,所以 docker exec <ctr> printenv 会失败,而错误文本看起来可能像一个值。要在不打印密钥的情况下检查容器实际收到了什么,可以比较哈希:
docker inspect <ctr> --format '{{range .Config.Env}}{{println .}}{{end}}' \
  | grep '^PROVIDER_API_PASSWORD=' | cut -d= -f2- | shasum -a 256
经验。 你的配置加载器就是一个解析器,它对特殊字符有自己的规则。在把随机生成的密码粘贴进去之前,先弄清楚这些规则。只检查「非空」的启动检查会放过被损坏的密钥。如果可以,在启动时用一次真实请求验证凭据,并把插值警告当作错误处理。
我们整体上改变了什么
修复本身都很小。更有价值的成果是一份简短的检查清单,我们现在把它应用到栈中的每个服务:
- 按 digest 固定镜像,适用于所有有状态或处于关键路径上的服务。有意识地升级,并在升级时对照限制检查启动内存。
- 根据实测的启动峰值设定内存限制,而不是凭稳态猜测,并留出余量。
- 用
docker events监视oom和die。不要只依赖某一次docker inspect快照。 - 每个自带迁移的服务使用一个数据库。
- 在延迟之后验证,而不只是在重启后立即验证。
- 必需的依赖不可用时,在请求处显式失败。不要返回带空字段的
200。 - 编辑 env 文件后运行
docker compose config,并把「variable is not set」视为阻断项。 - 让运维手册与修复保持同步,否则下一次重建会把 bug 带回来。
这些都不是 LLM 网关特有的。它适用于任何一个由一个人负责部署、凌晨三点没人会被叫醒的小型自托管栈。想了解更多在 VPS 上运行服务的内容,请参阅我们的 OpenClaw 自托管指南、OpenClaw 监控 和 OpenClaw 密钥管理。更早的一篇构建日志,请看我们如何把开通时间缩短到 3 分钟以内。
无需自己运维网关也能运行智能体
如果你想在 VPS 上运行 Codex 智能体,但不想自己运维这样一套栈,这正是 Office Claws 要做的事。你的智能体运行在你自己的 Contabo VPS 上,Codex 使用你现有的 ChatGPT 订阅,Office Claws 每月 $4.99。用以下命令安装 CLI:
curl -fsSL https://officeclaws.com/downloads/install.sh | sh