У Office Claws небольшой бэкенд: API на Go, Postgres, reverse proxy Caddy и self-hosted прокси LiteLLM — всё в одном стеке Docker Compose на одном VPS. LiteLLM — это LLM-шлюз. Во время провижининга бэкенд просит его выпустить для нового агента виртуальный ключ с ограниченным бюджетом.
Конфигурация самая обычная, и всё равно за одну неделю в июне она ломалась трижды. Ни один из сбоев не был экзотическим. Каждый какое-то время оставался незаметным — поэтому и было больно. Это build log: что мы увидели, что было не так на самом деле, что мы изменили и какой урок мы передали бы любому, кто держит похожий self-hosted стек.
| # | Инцидент | Как проявился | Исправление |
|---|---|---|---|
| 1 | Плавающий тег образа + тесный лимит памяти | Онбординг агента падал с невнятной ошибкой на клиенте | Закрепить по digest, поднять лимит, падать громко |
| 2 | Миграции шлюза стёрли общую схему | relation "users" does not exist после рестарта | Отдельная база данных для шлюза |
| 3 | $ в секрете, интерполированный Compose | Сервис стартовал нормально, секрет был молча испорчен | Экранировать как $$, проверять compose config |
Инцидент 1: плавающий тег притащил более тяжёлую сборку, и она ушла в OOM-цикл
Симптом. Новые агенты перестали доходить до конца настройки. Десктопное приложение падало на шаге онбординга с сообщением «LiteLLM virtual key and base URL are required». Это сообщение появлялось через несколько минут после того, как запрос на провижининг уже вернул успех, поэтому сначала мы подозревали клиент.
Первопричина. Наш compose-файл ссылался на LiteLLM по плавающему тегу:
litellm:
  image: ghcr.io/berriai/litellm:main-stable
  deploy:
    resources:
      limits:
        memory: 1500M
Обычный деплой подтянул то, на что в тот день указывал main-stable. Новой сборке для старта с двумя воркерами требовалось около 2,1 GiB. При лимите 1500M ядро убивало её до окончания прогрева, Docker перезапускал контейнер, и цикл повторялся примерно каждые 62 секунды. Когда мы это заметили, контейнер успел перезапуститься 4088 раз примерно за три дня.
Незаметным это оставалось по двум причинам:
- Наш бэкенд проглатывал ошибку. Когда выпуск ключа падал, обработчик провижининга писал warning в лог и возвращал
200с пустыми LLM-полями. Настоящая ошибка всплывала позже, на клиенте, в виде общего сообщения. - Очевидная диагностика врала.
docker inspectпоказывалRestartCountиExitCode, которые выглядели нормально, когда мы смотрели посреди цикла. Реально цикл стал виден, только когда мы начали смотреть события вживую:
docker events --filter container=<litellm-container> --filter event=oom --filter event=die
# ... oom
# ... die (exitCode=137)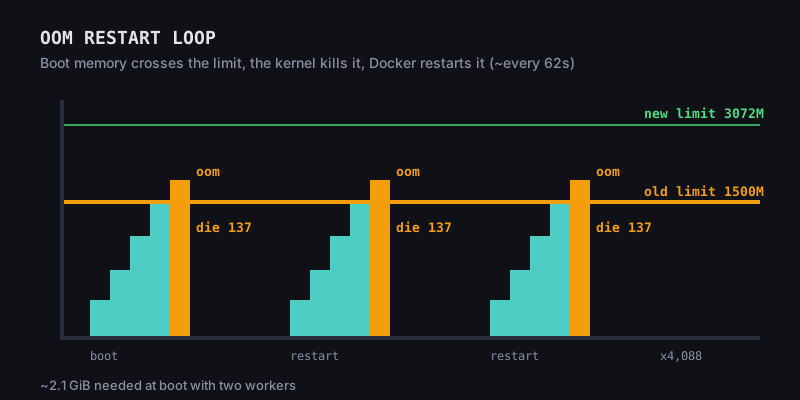
Исправление. Три изменения в одном PR:
litellm:
  # Pinned by digest. Bump deliberately: verify boot memory fits the limit first.
  image: ghcr.io/berriai/litellm@sha256:<digest-you-tested>
  deploy:
    resources:
      limits:
        # Boot memory of the pinned image is ~2.1G with two workers.
        memory: 3072M
А в обработчике провижининга неудачный выпуск ключа теперь — явный 502 (или 503, если шлюз не настроен) вместо 200 с пустыми полями. Ошибка, которую пользователь может сразу повторить, лучше той, что всплывёт позже в виде непонятного сообщения.
Чтобы узнать digest образа, который вы реально протестировали:
docker buildx imagetools inspect ghcr.io/berriai/litellm:main-stable
# or, for an image already pulled on the host:
docker inspect --format '{{index .RepoDigests 0}}' ghcr.io/berriai/litellm:main-stable
Урок. Плавающий тег — это непроверенное обновление при каждом деплое, а лимит памяти, подобранный под образ прошлого месяца, рано или поздно окажется мал. Закрепляйте образы, от которых зависите, по digest и относитесь к обновлению как к изменению, которое вы проверяете на память при старте, а не как к побочному эффекту деплоя. И если зависимость обязательна, падайте прямо в момент запроса. Фолбэки, которые выглядят опциональными, — это то место, где начинаются тихие инциденты.
Инцидент 2: миграции шлюза удалили таблицы нашего бэкенда
Симптом. После рестарта регистрация и логин начали падать с ошибкой:
ERROR: relation "users" does not exist (SQLSTATE 42P01)Странность в том, что логи бэкенда показывали: наши собственные миграции при старте применились без проблем. Быстрая проверка сразу после рестарта выглядела нормально. Через минуту таблиц уже не было.
Первопричина. Чтобы не усложнять конфигурацию, мы направили оба сервиса в одну и ту же базу данных Postgres:
# backend.env
DB_DSN=postgresql://app:<password>@postgres:5432/app

# litellm.env
DATABASE_URL=postgresql://app:<password>@postgres:5432/app   # same database
LiteLLM управляет своей схемой через Prisma. При каждом старте он сравнивает живую базу со своим schema.prisma. Таблиц нашего бэкенда (пользователи, агенты, записи о VPS и так далее) в схеме LiteLLM нет, поэтому для Prisma они выглядели как дрейф. В ответ он сбрасывал схему и заново применял свои миграции, удаляя все таблицы, которые ему не принадлежали.
Сброс происходил примерно через 40–70 секунд после старта. Эта задержка объясняла запутанные логи. Наш бэкенд создавал свои таблицы, шлюз заканчивал сравнение и стирал их, а любая проверка в первую минуту выглядела нормально.
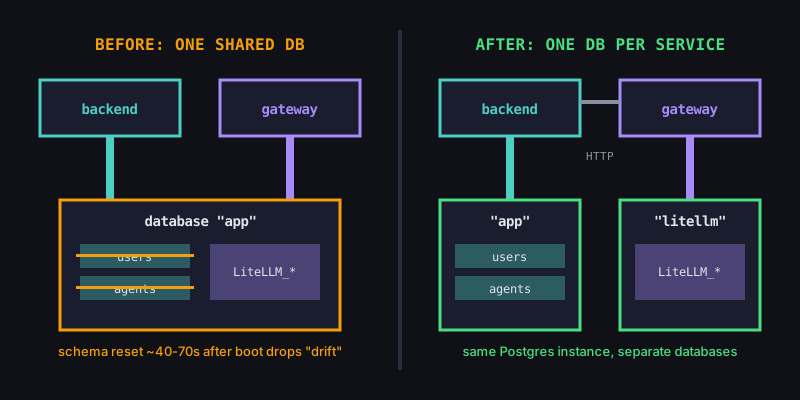
Исправление. Дать шлюзу собственную базу данных. Бэкенд общается с LiteLLM только по HTTP и никогда не читает его таблицы, так что причин делить одну базу не было.
CREATE DATABASE litellm OWNER app;# litellm.env
DATABASE_URL=postgresql://app:<password>@postgres:5432/litellmЗатем пересоздайте шлюз, чтобы он построил свои таблицы в litellm, перезапустите бэкенд, чтобы он заново создал свои таблицы в app, и удалите осиротевшие таблицы шлюза из старой базы. Для проверки мы ещё раз перезапустили шлюз, подождали дольше окна сравнения и убедились, что наши таблицы на месте, а регистрация возвращает 200.
Урок. Сторонние сервисы, которые сами управляют своей схемой, считают, что вся база данных принадлежит им. Не позволяйте двум инструментам миграций делить одну схему, если оба явно это не поддерживают. Отдельные базы на одном инстансе Postgres почти ничего не стоят. Кроме того, если сбой отложенный, проверяйте ещё раз после задержки: проверка через минуту после старта этот сбой бы не поймала. И наконец, обновите runbook. После исправления наши собственные заметки по настройке всё ещё описывали общую базу, а значит, пересборка по этим заметкам вернула бы баг обратно.
Инцидент 3: $ в секрете молча обнулился
Симптом. Почти никакого — и это самое страшное. Бэкенд стартовал и записал в лог, что клиент облачного провайдера инициализирован. Эта стартовая проверка подтверждала лишь то, что учётные данные не пустые. Сами учётные данные были неверными, так что любой реальный вызов API провалил бы аутентификацию.
Единственной видимой подсказкой был warning при docker compose up, который легко пролистать:
WARN[0000] The "Xk9def" variable is not set. Defaulting to a blank string.Xk9def не был переменной, которую мы когда-либо определяли (значение здесь выдуманное). Это были символы сразу после $ внутри одного из наших секретов.
Первопричина. Docker Compose v2 интерполирует значения в файлах env_file. Секрет вида:
PROVIDER_API_PASSWORD=abc$Xk9defчитается как abc + значение $Xk9def (не задано, значит пусто). Compose передаёт в контейнер укороченное, неверное значение без всякой ошибки.
Исправление. При записи env-файлов экранируйте каждый литеральный $ как $$, затем пересоздайте контейнер:
sed -i '/^PROVIDER_API_PASSWORD=/ s/\$/$$/g' secrets/backend.env
docker compose up -d --force-recreate backend
Мы также добавили проверку после записи любого файла с секретами. Она должна возвращать ноль совпадений:
docker compose config 2>&1 | grep "is not set"И ещё одна ловушка: образ нашего бэкенда минимальный, поэтому docker exec <ctr> printenv падает, а текст ошибки может выглядеть как значение. Чтобы проверить, что контейнер реально получил, не выводя секрет на экран, сравнивайте хэши:
docker inspect <ctr> --format '{{range .Config.Env}}{{println .}}{{end}}' \
  | grep '^PROVIDER_API_PASSWORD=' | cut -d= -f2- | shasum -a 256
Урок. Загрузчик конфигурации — это парсер, и у него свои правила обработки спецсимволов. Выясните эти правила до того, как вставлять в него случайно сгенерированный пароль. Стартовая проверка, которая проверяет только «не пусто», пропустит испорченный секрет. Если можете, проверяйте учётные данные реальным запросом при старте и считайте warning'и интерполяции ошибками.
Что мы изменили в целом
Сами исправления были небольшими. Полезнее оказался короткий чек-лист, который мы теперь применяем к каждому сервису в стеке:
- Закрепляйте образы по digest для всего, что хранит состояние или стоит на критическом пути. Обновляйтесь намеренно и при этом сверяйте память при старте с лимитом.
- Подбирайте лимиты памяти по измеренным пикам при старте, а не по прикидкам для стабильного режима, и оставляйте запас.
- Следите за
docker eventsна предметoomиdie. Не полагайтесь только на один снимокdocker inspect. - Отдельная база данных для каждого сервиса, который сам гоняет свои миграции.
- Проверяйте после задержки, а не только сразу после рестарта.
- Падайте громко прямо в запросе, когда обязательная зависимость недоступна. Никаких
200с пустыми полями. - Запускайте
docker compose configпосле правки env-файлов и считайте «variable is not set» блокером. - Синхронизируйте runbook с исправлением, иначе следующая пересборка вернёт баг.
Ничто из этого не специфично для LLM-шлюзов. Это касается любого небольшого self-hosted стека, где деплоит один человек и никого не будят в три часа ночи. Подробнее о работе сервисов на VPS — в нашем руководстве по self-hosted OpenClaw, мониторинге OpenClaw и управлении секретами в OpenClaw. А в одном из прошлых build log'ов мы рассказывали, как довели провижининг до менее чем 3 минут.
Агенты без собственного шлюза
Если вам нужны агенты Codex на VPS, но не хочется обслуживать такой стек, — именно этим занимается Office Claws. Ваши агенты работают на вашем собственном VPS в Contabo, Codex использует вашу существующую подписку ChatGPT, а Office Claws стоит $4.99/мес. Установите CLI командой:
curl -fsSL https://officeclaws.com/downloads/install.sh | sh